
샘플 준비: 당신의 DNA를 시퀀싱하기 전에 무슨 일이 일어나나요?
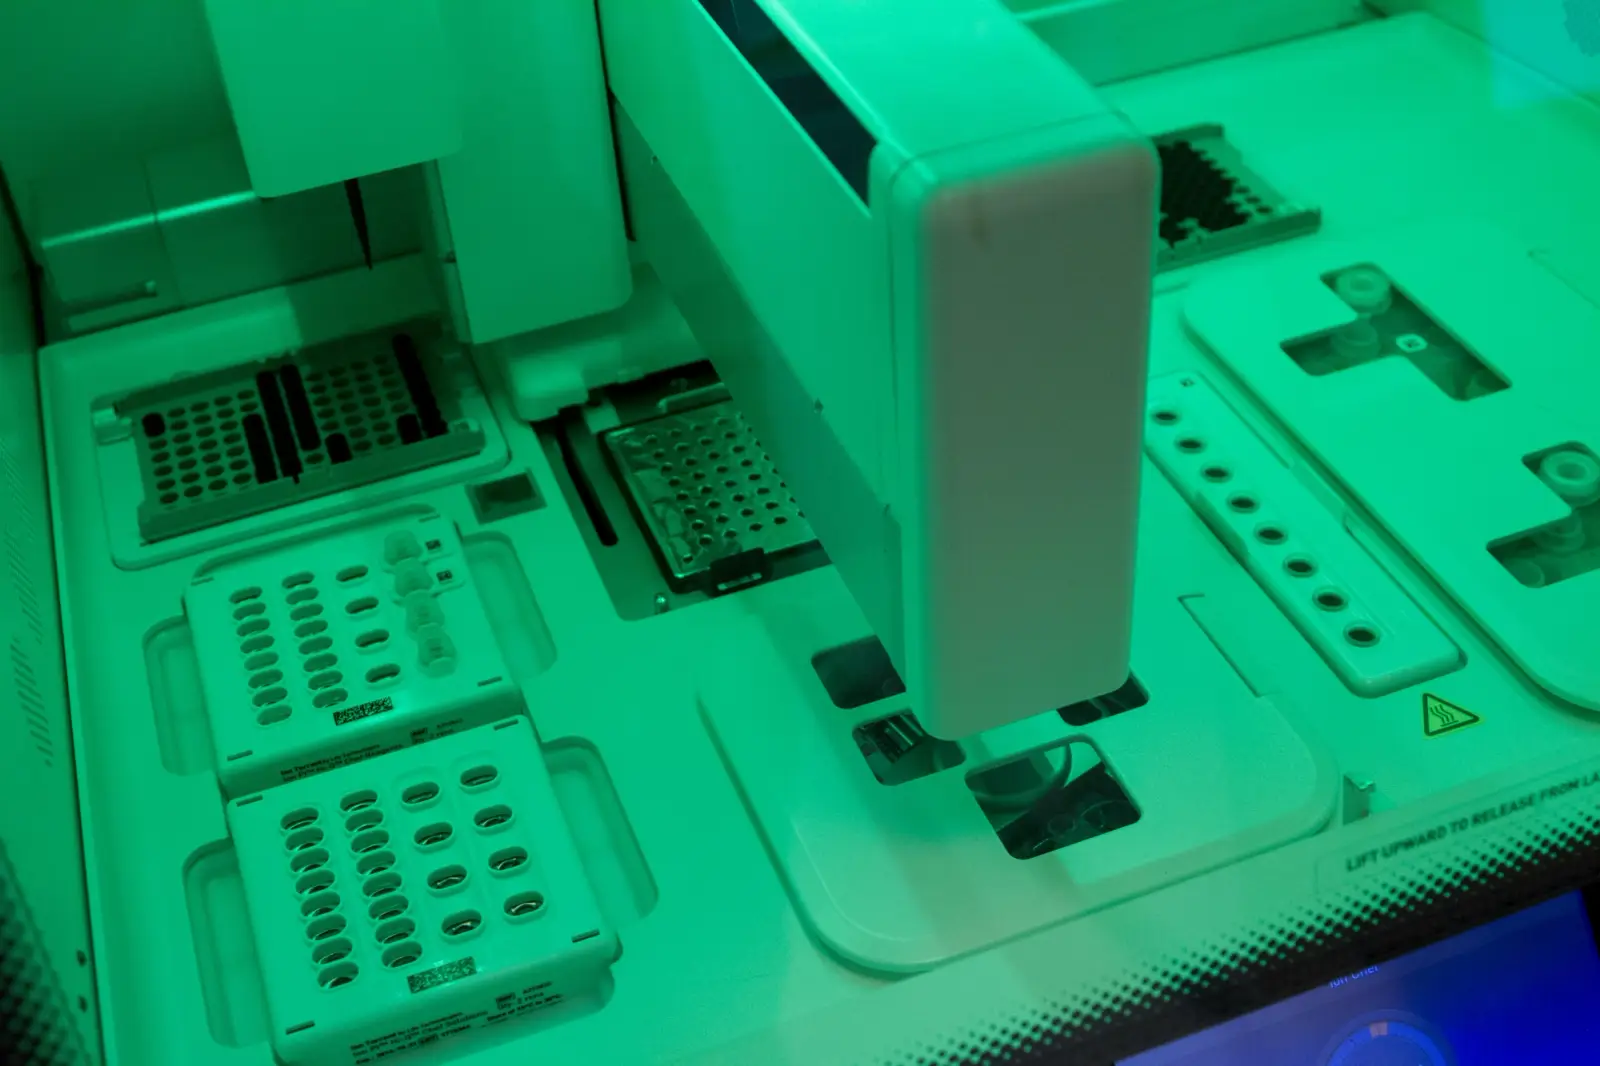
DNA를 시퀀싱하기 전에, 먼저 시퀀서에 넣을 수 있는 개별 분자를 준비해야 합니다.
4분 읽기
시퀀싱의 작동 원리
최신 장비가 수백만 개의 짧은 DNA 조각을 한꺼번에 읽어 전체 게놈을 해독하는 방법과, 각 글자를 여러 번 읽는 이유.
Matt Brown 검토 · 2026년 10월 12일 · 5분 읽기
사람의 유전체는 약 30억 개의 글자로 이루어져 있으며, 네 가지 화학 염기 A, C, G, T로 쓰여 있습니다. 유전체를 읽는다는 것은 이 글자들의 순서를 알아내는 것입니다. 차세대 염기서열 분석(NGS)은 DNA의 짧은 조각 수백만 개를 동시에 읽어, 사람의 전체 유전체를 빠르고 일상적으로 읽을 수 있게 만든 기술들을 통칭합니다.
최초의 실용적인 방법인 생어 염기서열 분석법은 1970년대에 개발되었습니다. 이 방법은 반응 한 번에 약 1,000개 글자 정도의 DNA 한 구간만 읽습니다. 매우 정확하여 지금도 개별 결과를 확인하는 데 쓰이지만, 이 방식으로 전체 유전체를 읽으려면 수백만 번 반복해야 합니다. 이 방법으로 최초의 기준 유전체를 만든 휴먼 게놈 프로젝트는 13년이 걸렸고 전 세계 여러 연구실이 참여했습니다.
NGS는 유전체를 수백만 개의 짧은 조각으로 나누어 모두 동시에 읽습니다. 각 조각은 리드라고 불리는 짧은 서열을 만들어내며, 장비 한 번의 가동으로 수십억 개의 리드를 얻을 수 있습니다. 이후 소프트웨어가 리드들을 다시 이어 붙입니다. 이러한 병렬 처리 덕분에 십 년이 걸리던 프로젝트가 연구실에서 며칠 만에 가능한 일이 되었습니다.
어떤 리드도 완벽하지 않기 때문에 유전체의 각 위치는 겹치는 조각들에 의해 여러 번 읽힙니다. 한 위치를 덮는 리드의 평균 개수를 커버리지 또는 깊이라고 합니다. 임상 전장 유전체 분석은 보통 평균 약 30x를 목표로 합니다. 즉 각 글자를 약 30번 읽는다는 뜻이며, 이를 통해 우연한 읽기 오류와 실제 차이를 구별할 수 있습니다.
원시 리드는 시작일 뿐입니다. 생물정보학 소프트웨어가 각 리드를 기준 사람 유전체의 제자리에 정렬한 뒤, 본인의 서열을 기준 서열과 비교하여 차이가 나는 위치를 찾습니다. 이 단계를 변이 검출이라고 합니다. 찾아낸 변이에는 이미 알려진 정보를 바탕으로 주석이 달립니다.
위에서 설명한 방법은 정확도가 높고 경제적인 짧은 리드를 만들어내며, 전장 유전체 분석의 핵심 기술입니다. 긴 리드 기술은 수천 글자 길이의 단일 분자를 읽습니다. 반복 영역과 큰 구조 변화를 가로지르는 데 더 적합하며, 두 방식은 점점 함께 사용되고 있습니다.
NGS는 유전체를 병렬로 읽기 때문에, 미리 선택한 몇 개의 위치만 분석하는 대신 전체를 시퀀싱하는 것이 현실적입니다. 이것이 전장 유전체 시퀀싱과 선택된 유전자나 알려진 마커만 살펴보는 검사의 차이입니다.
키트를 집으로 보내드립니다. 진단 결정에 사용되는 임상 표준으로 전장 유전체를 분석합니다. 의료진이 바로 활용할 수 있는 보고서를 6~8주 안에 Genome Manager로 전달하며, 보고서는 영구적으로 보관되고 과학이 발전함에 따라 업데이트됩니다.
배송비 무료 · 결과는 6~8주 내 제공