
Monstervoorbereiding: wat gebeurt er voordat we uw DNA sequencen?
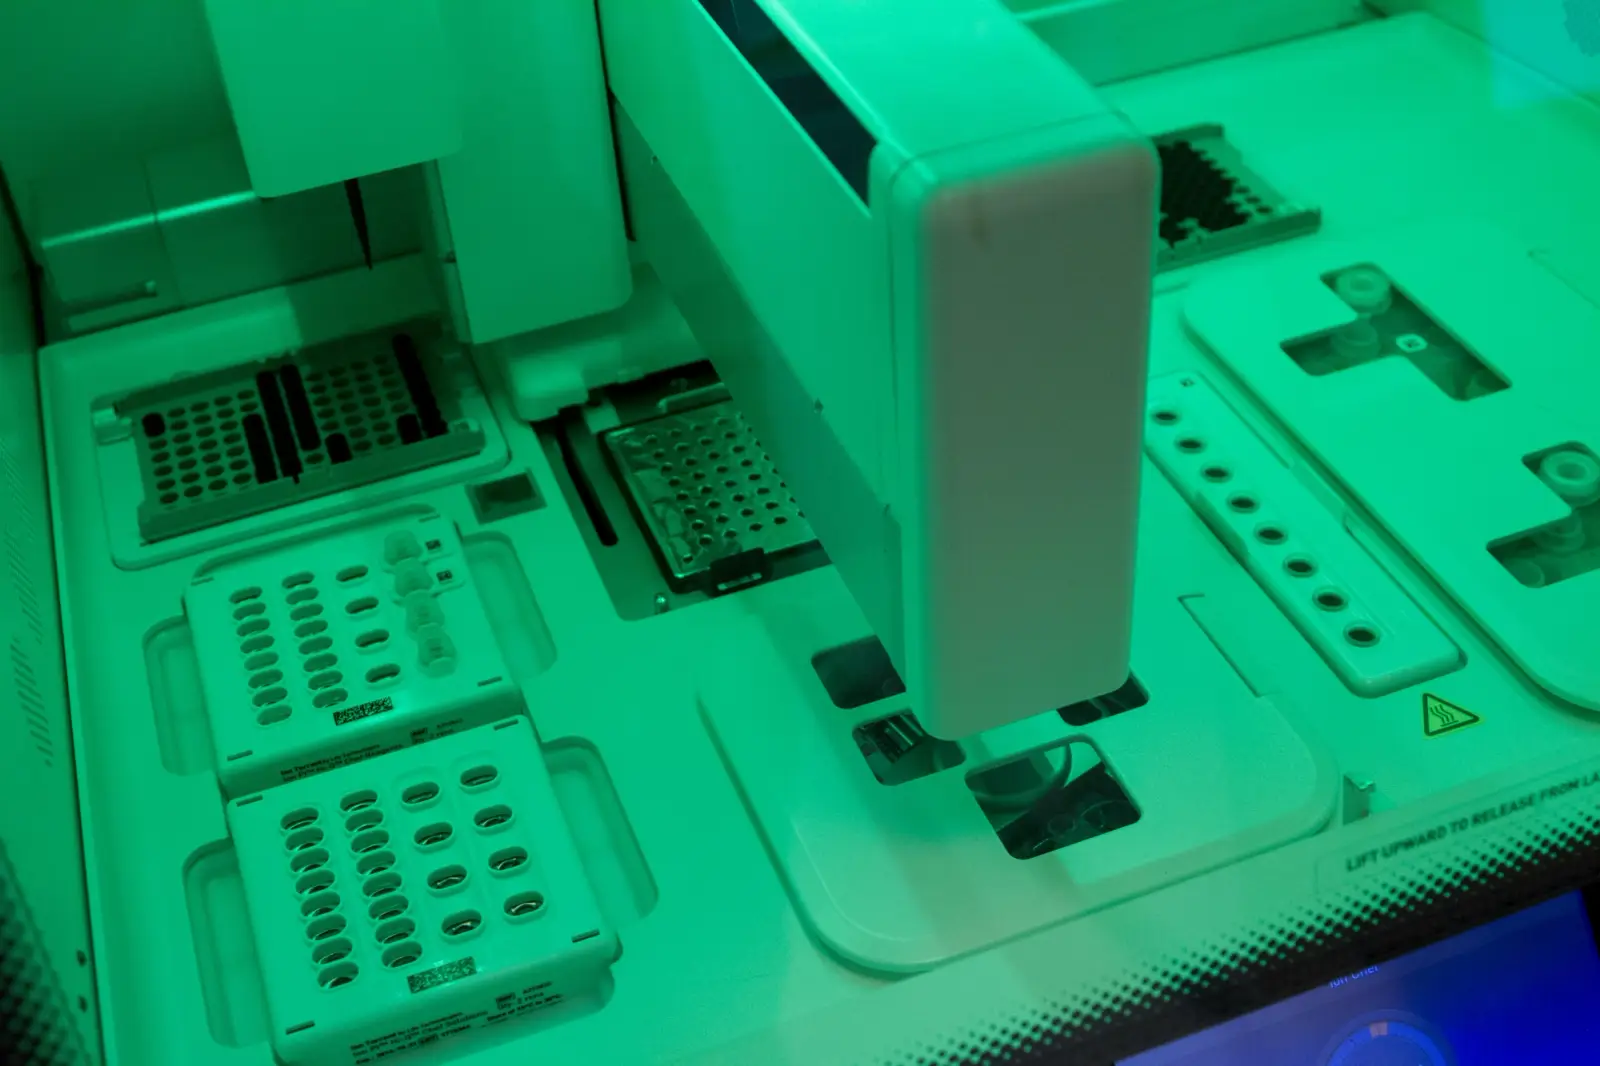
Voordat we uw DNA kunnen sequencen, moeten we afzonderlijke moleculen voorbereiden die in onze sequencer geladen kunnen worden.
4 min leestijd
Hoe sequencing werkt
Hoe moderne apparaten een volledig genoom lezen door miljoenen korte DNA-fragmenten tegelijk te sequencen, en waarom elke letter vele malen wordt gelezen.
Beoordeeld door Matt Brown op 12 oktober 2026 · 5 min leestijd
Uw genoom bestaat uit ongeveer drie miljard letters, opgebouwd uit vier chemische bases: A, C, G en T. Het lezen ervan betekent dat de volgorde van die letters wordt vastgesteld. Next-generation sequencing (NGS) is de verzameling technieken die het lezen van een volledig menselijk genoom snel en routinematig heeft gemaakt, doordat miljoenen korte stukjes DNA tegelijk worden gelezen in plaats van één voor één.
De eerste praktische methode, Sanger-sequencing, werd in de jaren zeventig ontwikkeld. Per reactie leest ze één DNA-stuk van maximaal ongeveer duizend letters. Ze is zeer nauwkeurig en wordt nog steeds gebruikt om afzonderlijke resultaten te bevestigen, maar om zo een volledig genoom te lezen moet de methode miljoenen keren worden herhaald. Het Human Genome Project, dat deze methode gebruikte om het eerste referentiegenoom te produceren, duurde dertien jaar en vergde laboratoria over de hele wereld.
NGS breekt het genoom op in miljoenen korte fragmenten en leest ze allemaal tegelijk. Elk fragment levert een korte reeks op, een read genoemd, en één run van een apparaat kan er miljarden opleveren. Software zet de reads vervolgens weer in elkaar. Dankzij die parallelliteit is een project dat ooit tien jaar duurde iets geworden dat een laboratorium in dagen kan uitvoeren.
Geen enkele read is perfect, daarom wordt elke positie in het genoom door overlappende fragmenten vele keren gelezen. Het gemiddelde aantal reads dat een positie bedekt, heet dekking of diepte. Klinische volledige genoomsequencing streeft doorgaans naar een gemiddelde van ongeveer 30x, wat betekent dat elke letter ongeveer dertig keer wordt gelezen. Zo kunnen echte verschillen worden onderscheiden van incidentele leesfouten.
Ruwe reads vormen slechts het begin. Bioinformatica-software lijnt elke read uit op de plaats die hij inneemt in een referentie-genoom van de mens, en vergelijkt daarna uw sequentie met de referentie om de posities te vinden waar ze verschillen. Deze stap heet variant calling. De gevonden varianten worden vervolgens geannoteerd met wat er over hen bekend is.
De hierboven beschreven methode levert korte reads op, die zeer nauwkeurig en economisch zijn, en is het werkpaard van volledige genoomsequencing. Technieken met lange reads lezen afzonderlijke moleculen van duizenden letters lang. Ze zijn beter in het overbruggen van repetitieve regio's en grote structurele veranderingen, en de twee benaderingen worden steeds vaker samen gebruikt.
Omdat NGS het genoom parallel uitleest, is het praktisch om het hele genoom te sequencen in plaats van een handvol vooraf gekozen posities. Dat is het verschil tussen whole genome sequencing en tests die alleen naar geselecteerde genen of bekende markers kijken.
Eén kit, bij u thuisbezorgd. Uw volledige genoom gesequencet volgens de klinische standaard die wordt gebruikt voor diagnostische beslissingen. Binnen 6–8 weken ontvangt u in uw Genome Manager rapporten die geschikt zijn voor gebruik door uw arts — permanent beschikbaar en bijgewerkt naarmate de wetenschap vordert.
Gratis verzending · Resultaten binnen 6–8 weken